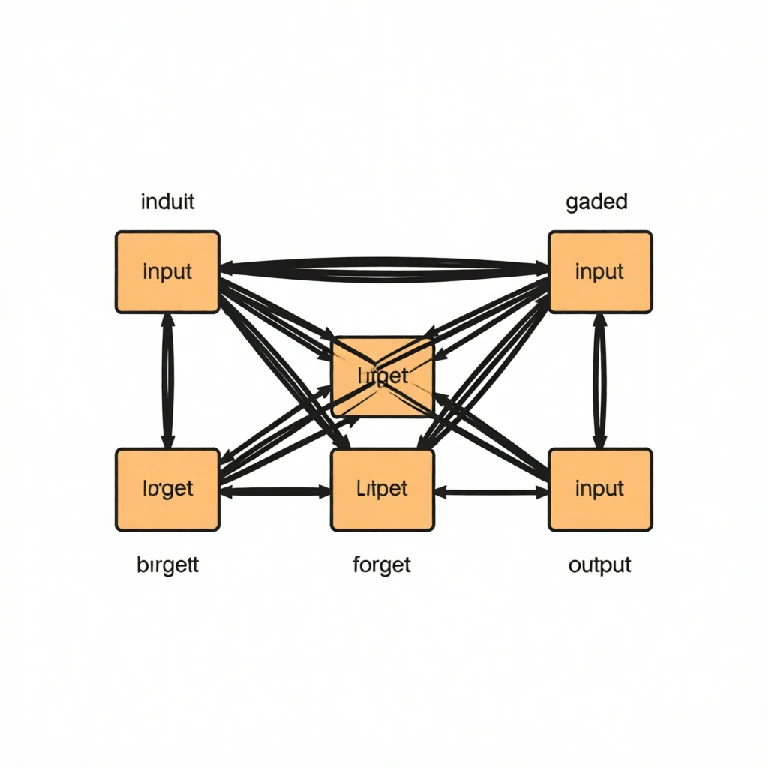
Hvert ord i en sætning kan relateres til alle andre ord. Selvopmærksomhed beregner disse relationer inden for en enkelt sekvens, hvor hver position samler information fra alle de andre. Det er kerneoperationen inde i transformeren.
Mekanismen projicerer hvert token til en forespørgsel, nøgle og værdi. Scorer mellem forespørgsler og nøgler bestemmer opmærksomhedsvægte, som kombinerer værdierne i en ny repræsentation. Multi-head opmærksomhed kører flere af disse parallelt for at registrere forskellige typer relationer.
Nøgleegenskaber
- Parallel beregning på tværs af positioner
- Direkte stier mellem fjerne tokens
- Lærte opmærksomhedsmønstre
- Skalerbarhed med sekvenslængde
Omkostningerne vokser kvadratisk med sekvensens længde, hvilket begrænser, hvor meget tekst en model kan behandle på én gang. Sparsom opmærksomhed, glidende vinduer og lineære tilnærmelser reducerer byrden med en vis omkostning i udtryksevnen.
Comments
No comments yet. Be the first to share a thought.
Leave a comment