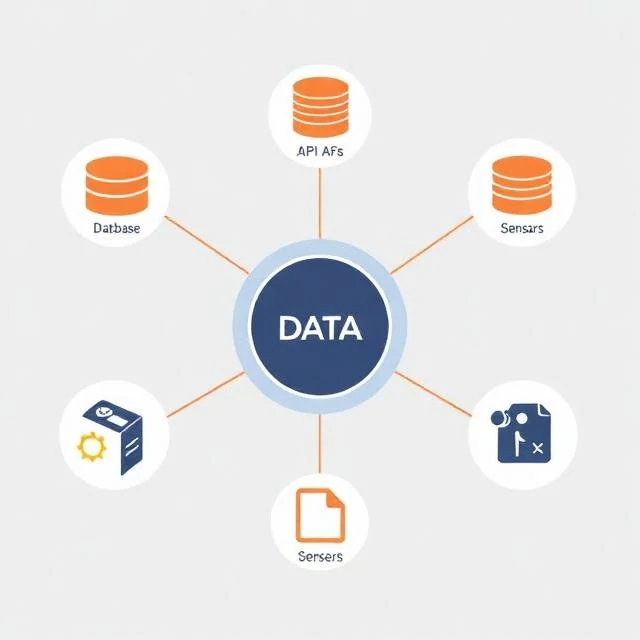
En datakilde er der data kommer fra. Databaser, API-er, loggfiler, sensorer, undersøkelser og offentlige registre fungerer alle som kilder. Kilden bestemmer dataenes struktur, kvalitet og pålitelighet. En godt vedlikeholdt database med begrensninger og validering produserer renere data enn et regneark som fylles ut for hånd. En sensor med kalibreringsavvik produserer skjeve avlesninger. Et offentlig datasett kan være ufullstendig eller utdatert.
Det er viktig å kjenne kilden for å kunne stole på dataene. Hvor kom de fra? Hvem samlet dem inn? Når? Hvordan? Hva var metoden? Hva ble ekskludert? Disse spørsmålene avgjør hva dataene kan og ikke kan støtte. Data fra en undersøkelse av 100 personer kan ikke støtte påstander om en befolkning på millioner. Data fra et system som bare logger vellykkede transaksjoner, overser feilene. Data fra en leverandør kan være nøyaktige for deres formål og feil for ditt. Kilden påvirker også pipelinen. En database med et stabilt skjema er enklere å integrere enn et nettsted som endrer HTML-koden hver måned. Et API med hastighetsgrenser begrenser hvor mye data du kan hente. En fil som ankommer manuelt er utsatt for forsinkelser og feil. Kilden er fundamentet. Et svakt fundament undergraver alt som er bygget oppå det.
Vanlige datakilder
- Databaser – strukturerte poster fra applikasjoner
- API-er – programmatisk tilgang til eksterne systemer
- Loggfiler – system- og programhendelser
- Sensorer – kontinuerlige fysiske målinger
- Undersøkelser – strukturerte svar fra folk
- Offentlige registre – offentlige og åpne datasett
Før du stoler på dataene, bør du forstå kilden. Svarene er ofte mer avslørende enn selve dataene.
Comments
No comments yet. Be the first to share a thought.
Leave a comment