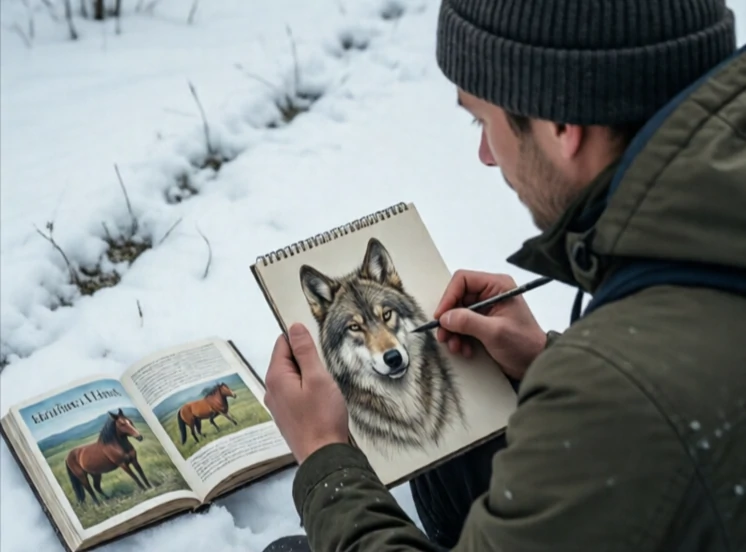
即使从未见过斑马的孩子,只要被告知斑马长得像带条纹的马,也能认出它来。零样本学习要求机器做类似的事情:利用属性描述或语义关系等辅助信息,处理它们从未接受过训练的类别或任务。
在图像分类中,一个零样本模型可能只训练过猫和狗的图像,但却被要求识别狼。如果模型已经学习了“有毛”、“有尖耳朵”和“群居”等属性,它就可以将这些属性组合成狼的特征,而无需实际观察过狼。连接已见类别和未见类别的桥梁通常是共享的语义空间,这个空间通常由文本描述或知识图谱构建而成。
为什么这很重要
- 新类别层出不穷,给它们贴标签却很慢。
- 有些类别的样本稀少,或者根本无法大规模采集。
- 现在,大型语言模型仅凭提示就能执行许多零样本任务。
- 它降低了将模型部署到新领域的成本。
在大多数基准测试中,零样本学习的性能仍然落后于监督学习。当辅助描述信息丰富且未见过的类别与训练分布接近时,这种差距会缩小。当两者相距甚远时,模型的预测结果往往不准确,而且常常过于自信。
Comments
No comments yet. Be the first to share a thought.
Leave a comment