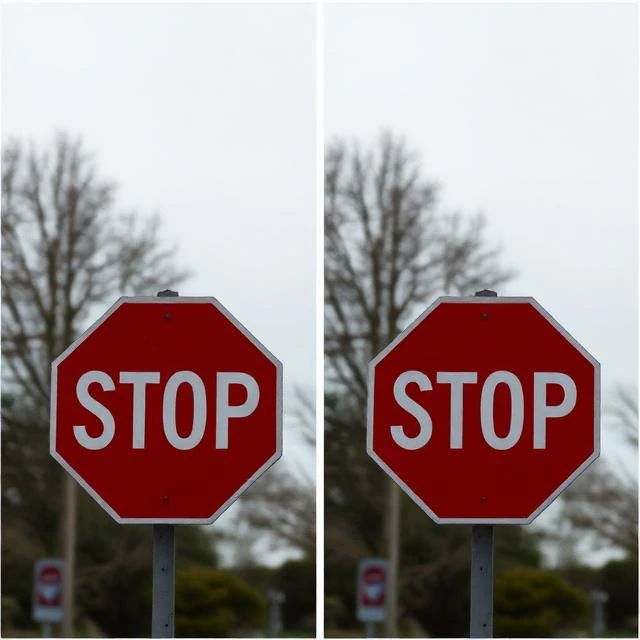
Verändert man ein paar Pixel in einem Bild, erkennt ein Klassifikator etwas völlig anderes. Fügt man einem Stoppschild unmerkliches Rauschen hinzu, interpretiert ein autonomes Fahrsystem es möglicherweise als Geschwindigkeitsbegrenzung. Diese manipulierten Eingaben sind sogenannte Adversarial Examples und verdeutlichen, wie unterschiedlich Maschinen und Menschen die Welt wahrnehmen.
Forscher erzeugen sie, indem sie den Gradienten der Verlustfunktion des Modells in Bezug auf die Eingabe berechnen und die Eingabe anschließend in die Richtung verschieben, die den Fehler maximiert. Die Änderung ist oft mit bloßem Auge nicht sichtbar. Die schnelle Gradientensignaturmethode und der projizierte Gradientenabstieg sind zwei gängige Verfahren.
Warum sie wichtig sind
- Sicherheitssysteme können absichtlich getäuscht werden.
- Autonome Fahrzeuge können Schilder falsch interpretieren.
- Medizinische Bildgebungsmodelle können manipuliert werden
- Sprachsysteme können mit versteckten Audiodateien angegriffen werden.
Es gibt zwar Verteidigungsmechanismen, darunter Gegnertraining und Eingabebereinigung, aber keiner ist vollkommen zuverlässig. Jede neue Verteidigungsmaßnahme wird in der Regel durch einen neuen Angriff überwunden, wodurch sich das Feld ständig weiterentwickelt.
Comments (3)
Leave a comment